L’IA est l’outil le plus puissant que nous ayons eu.
Reste à en garder la maîtrise.
TimAtlas encadre le travail de l’IA sur votre système d’information : le référentiel dit ce qui doit être fait, prouve ce qui a été fait, et vous arbitrez. Steppium, notre solution agentique, a été conçue, produite et documentée ainsi.
Sans contrôle ni maîtrise, on peut faire n’importe quoi
TimAtlas est né de l’expertise de Timorga et des problèmes que rencontrent ses clients. Quatre d’entre eux reviennent dans presque tous les projets où l’IA produit du code sans référentiel pour l’encadrer.
Des chemins parallèles, en masse
Face à un correctif, l’IA ajoute volontiers une implémentation nouvelle plutôt que de toucher à celle qui existe. Quelques semaines plus tard, la même fonction existe cinq fois et plus personne ne sait laquelle tourne réellement.
C’est le symptôme le plus coûteux, et le plus difficile à voir venir.
Rien de documenté
La documentation reste la tâche qu’on fera après — et qu’on ne fait jamais, parce que le code avance plus vite qu’elle. Au bout de quelques mois, le système n’est plus décrit nulle part.
Rien de reproductible
Impossible de refaire le chemin qui a mené au résultat : ni de le vérifier, ni de le corriger à la racine, ni de l’appliquer ailleurs. Chaque correction repart de zéro.
Plus rien de maintenable
Un volume de code produit bien au-delà de ce qu’une équipe peut relire, comprendre et reprendre. La vitesse initiale est réelle ; elle se paie ensuite, et plus cher.
Maîtriser et contrôler l’usage de l’outil
Deux gestes différents, et il faut les deux. Sans le premier, l’IA part où elle veut. Sans le second, vous la croyez sur parole.
Maîtriser — décider ce qui se fait
L’IA ne part pas d’une consigne en langage naturel, elle part d’un référentiel que vous avez arbitré : le cadrage, les domaines, le modèle de données, le plan de développement. Elle exécute une intention établie, pas une intention devinée.
C’est ce qui sépare un outil qu’on dirige d’un outil qu’on subit.
Contrôler — vérifier ce qui a été fait
Chaque chose produite est rattachée à ce qui la justifie et à la ligne qui la porte. Ce qui est fait, ce qui reste, ce qui n’est couvert par aucun test : c’est mesuré, pas déclaré.
Un item « implémenté » n’est pas un item « validé ». Le référentiel ne confond pas les deux.
Ce que TimAtlas construit
Un référentiel, une trajectoire, et quelqu’un à côté de vous pendant le trajet. Dans cet ordre, parce qu’on ne trace pas une route sans savoir d’où l’on part.
Le référentiel — construit, pas deviné
De l'analyse approfondie de vos applications, de vos sources et de votre documentation, TimAtlas construit un référentiel : objets d’architecture, fonctionnalités, règles de gestion, données, dépendances, traitements.
Rien n’y entre sans ce qui le fonde : une décision que vous prenez, ou la ligne de code qui la démontre. Et ce qu’on n’a pas pu établir est déclaré tel quel, pas comblé.
La route à parcourir — où vous voulez aller
De la coconstruction avec vous de vos besoins et de vos objectifs, TimAtlas construit la route à parcourir : ce qu’il faut faire, dans quel ordre, ce que chaque étape produit et ce qu’elle débloque.
Une trajectoire qui part de l’état réel du système, pas de l’état supposé. C’est la différence entre un plan qui tient et un plan qu’on refait au premier comité.
L’accompagnement — pendant tout le trajet
À chaque étape, le référentiel se remet à jour et produit ses livrables : la documentation suit le système au lieu de vieillir derrière lui, et l’audit se refait à la demande plutôt qu’une fois par an.
Timorga est à côté de vous sur toute la transformation — pas seulement le temps de brancher l’outil.
Six modèles, tirés du même référentiel
Aucun de ces modèles n’est saisi à la main, et aucun n’est deviné. Ils se construisent — chaque élément adossé à ce qui le fonde : ce que vous décidez, ou ce que votre code démontre. Vous tranchez les noms. Et quand le système bouge, ils le disent, au lieu de vieillir en silence.
Cartographie ArchiMate
Les trois couches métier, application et technologie, construites à votre vocabulaire — depuis vos décisions d’architecture, et confrontées au code quand il y en a un. Vues par domaine, par processus, par acteur, plus les viewpoints standards — paysage, coopération applicative, structure d’information, réalisation de service.
39 vues, 9 993 éléments et 13 462 relations sur notre propre dépôt. Plafond de 30 éléments par vue : une carte illisible ne renseigne personne.
Processus BPMN 2.0
Les processus métier en notation OMG, modelés avec vous dans l’atelier — et confrontés au code lui-même lorsqu’il existe. Tâches utilisateur, service, script, passerelles et événements.
Garde anti-invention : un enchaînement que le référentiel n’atteste pas n’est pas tracé — il est compté comme refusé, et vous voyez le compte.
Cas complexes CMMN 1.1
Le travail qui ne rentre pas dans un enchaînement figé : instruction d’un dossier, gestion d’exception, décision au cas par cas. Là où BPMN force un ordre qui n’existe pas, CMMN décrit des tâches disponibles sous condition.
Modeleur écrit pour TimAtlas : Camunda 8 ayant abandonné CMMN, il n’existait plus d’outil à reprendre.
Cas d’usage UML 2.5
Acteurs, cas d’usage et leurs quatre relations — association, inclusion, extension, généralisation. Une vue par acteur, pas un diagramme unique où plus personne ne retrouve son rôle.
La règle « une vue par acteur » vient d’un cas réel : trois acteurs dans une seule vue avaient donné un plat de spaghettis.
Modèle de données
Entités, attributs typés, rôle de clé, cardinalités, et le dictionnaire jusqu’au champ. Construit avec vous, et confronté au DDL, aux copybooks COBOL, aux DBD IMS, à l’ORM — Entity Framework, Mongoose — ou au schéma JSON, quand ces sources existent. Les données sensibles sont marquées PII, RGPD, santé ou financier, uniquement sur preuve.
Cadré par l’usage réel : sur un projet, 747 tables au catalogue pour environ 26 réellement touchées par le code. Une cardinalité non déclarée reste « inconnue », elle n’est pas devinée.
Règles de gestion
Gardes conditionnelles, seuils, transitions d’état, attributs de validation, contraintes CHECK, barèmes à paliers : six formes que vous posez au cadrage quand le système est à construire, et que l’on retrouve dans le code par leur structure — jamais par leur vocabulaire — quand il existe déjà. Chacune est localisée à la ligne et rattachée au composant qui la porte.
824 règles extraites sur notre parc. Périmètre actuel : C# et SQL — et c’est vous qui leur donnez leur nom métier, la machine ne fait que les trouver.
Deux fenêtres. Un seul produit.
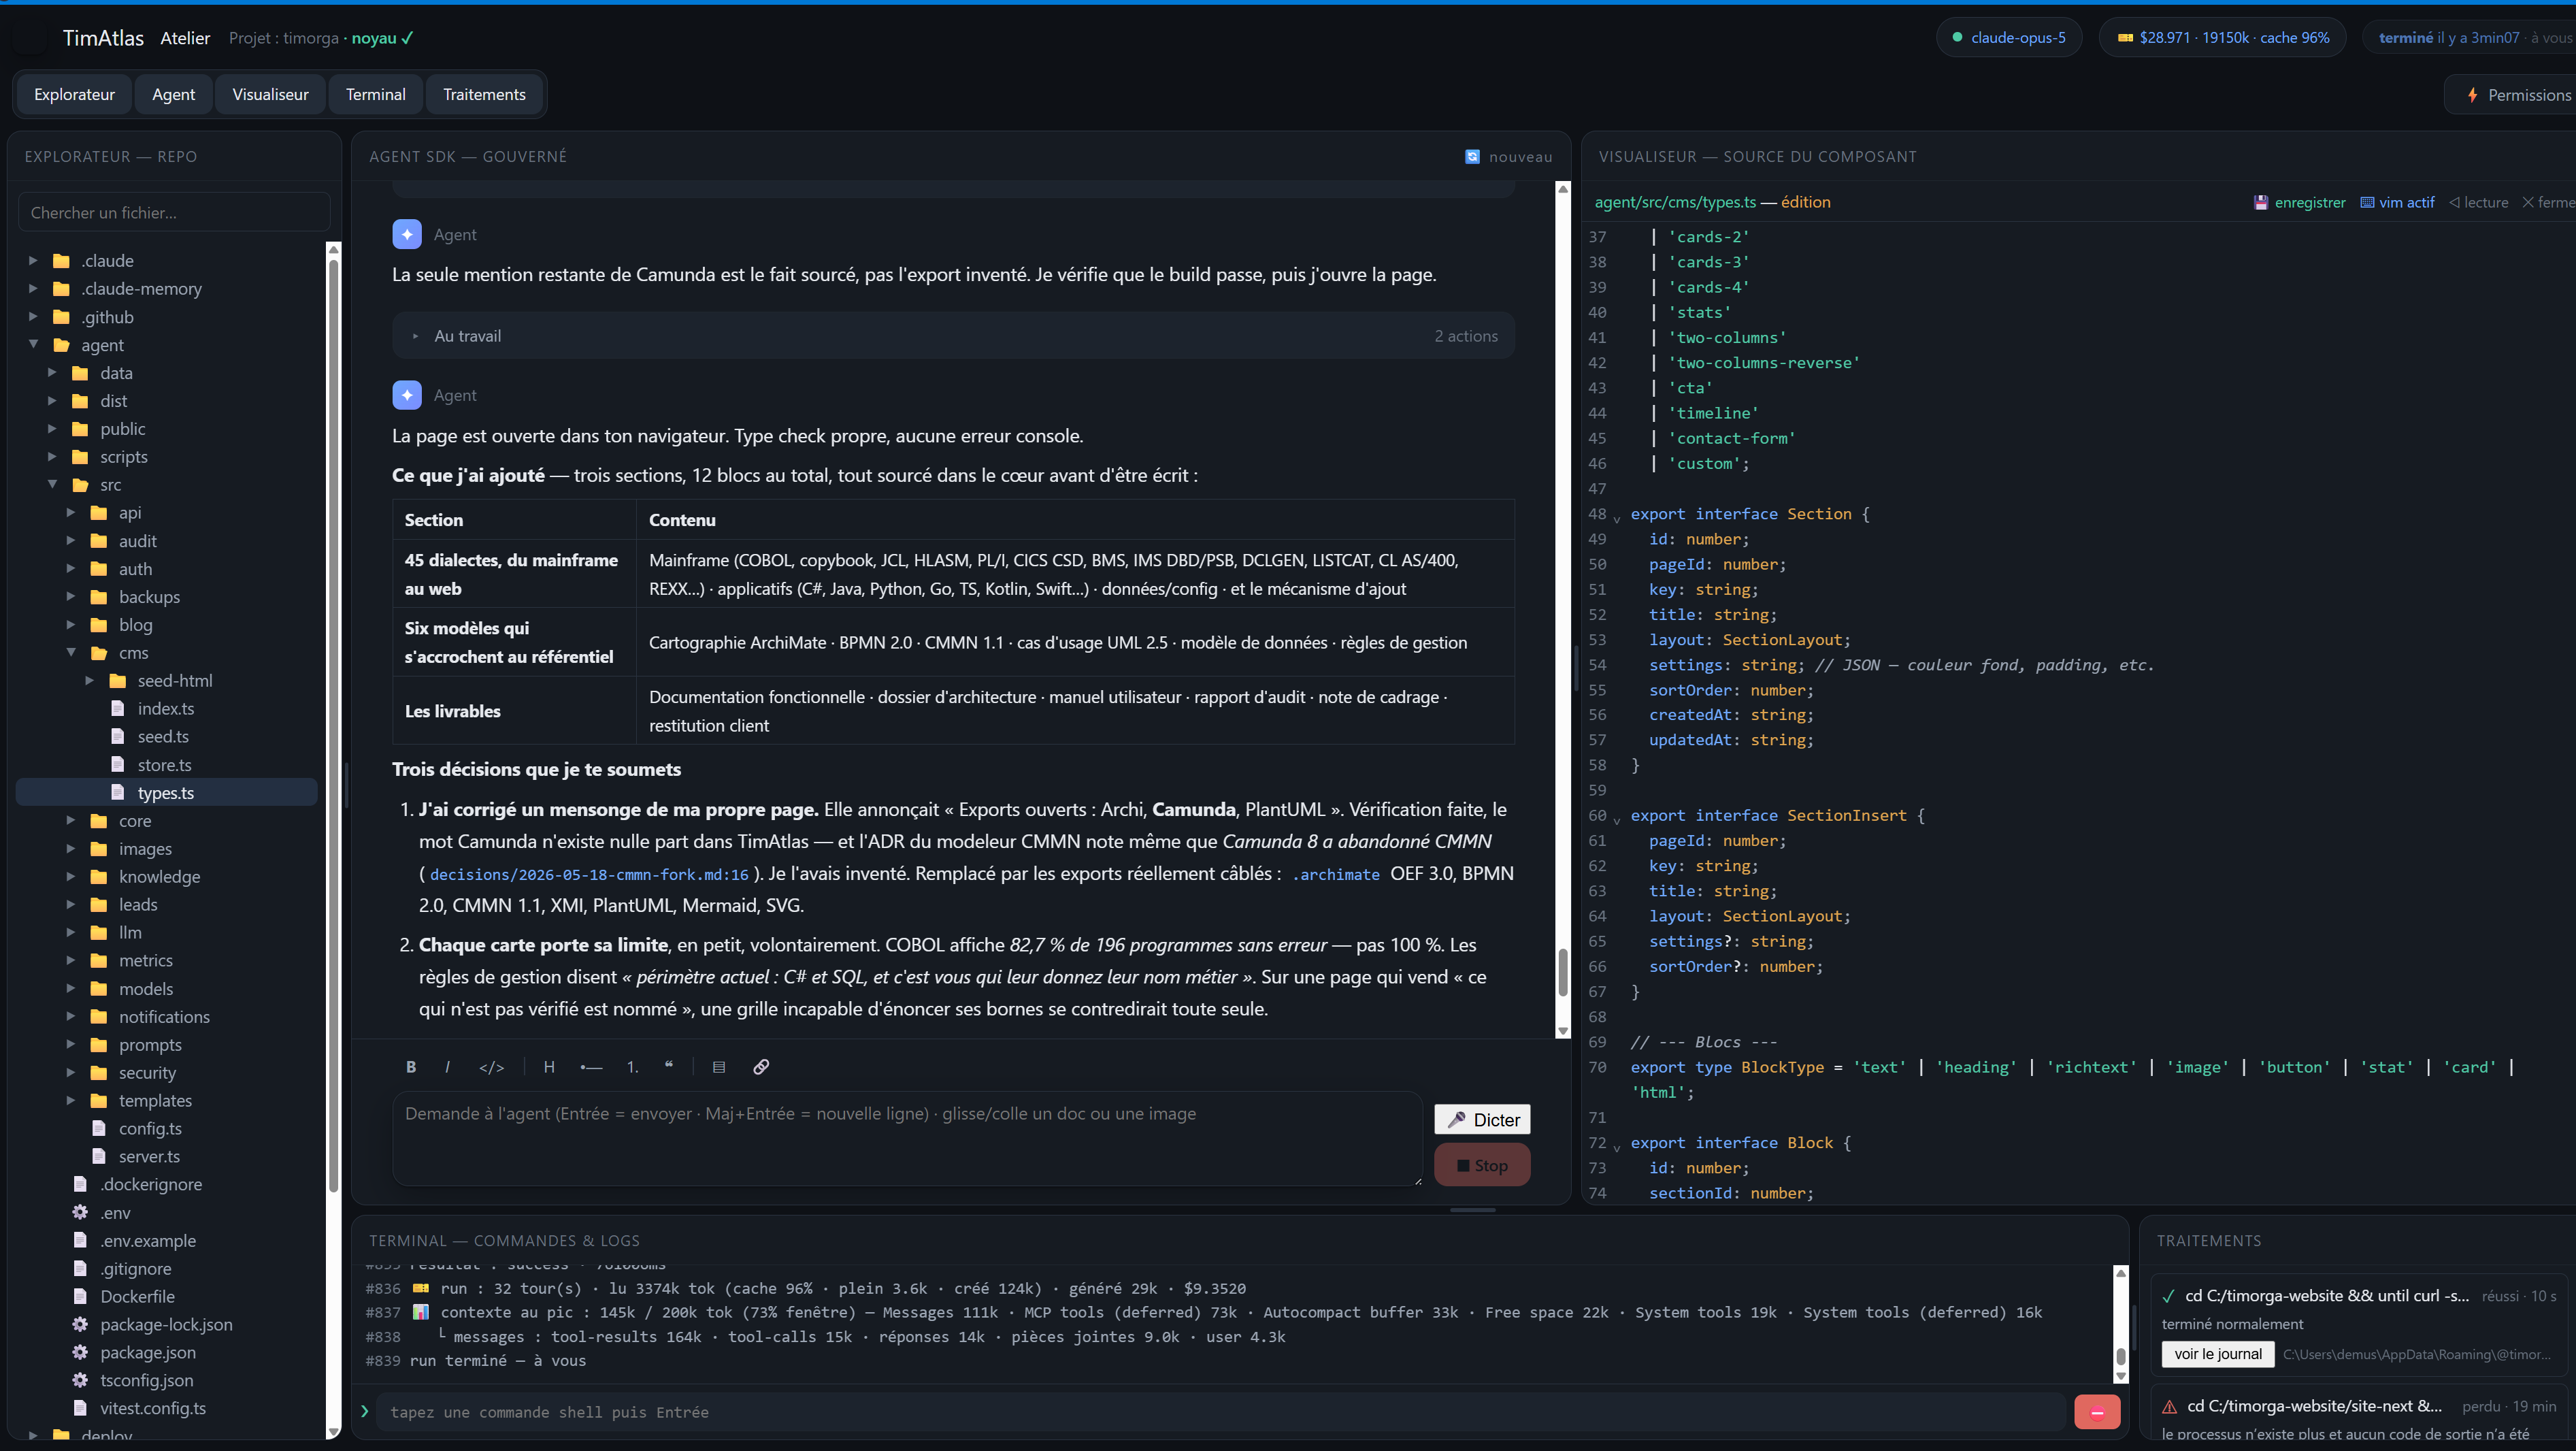
Ni maître ni suiveur : deux fenêtres qui se répondent. L’une est le lieu où le travail se fait, l’autre dit où en est chaque brique.
L’atelier — là où le travail se fait
Une application de bureau, sur votre poste : votre code ne part nulle part. Dans une seule fenêtre, l’agent conduit le travail et vous lui parlez, votre dépôt s’explore, le terminal reste sous vos yeux, et les traitements en cours s’arrêtent d’un bouton.
L’agent conçoit, produit et montre — il rend la main à chaque décision.
Le cockpit — l’état de chaque brique
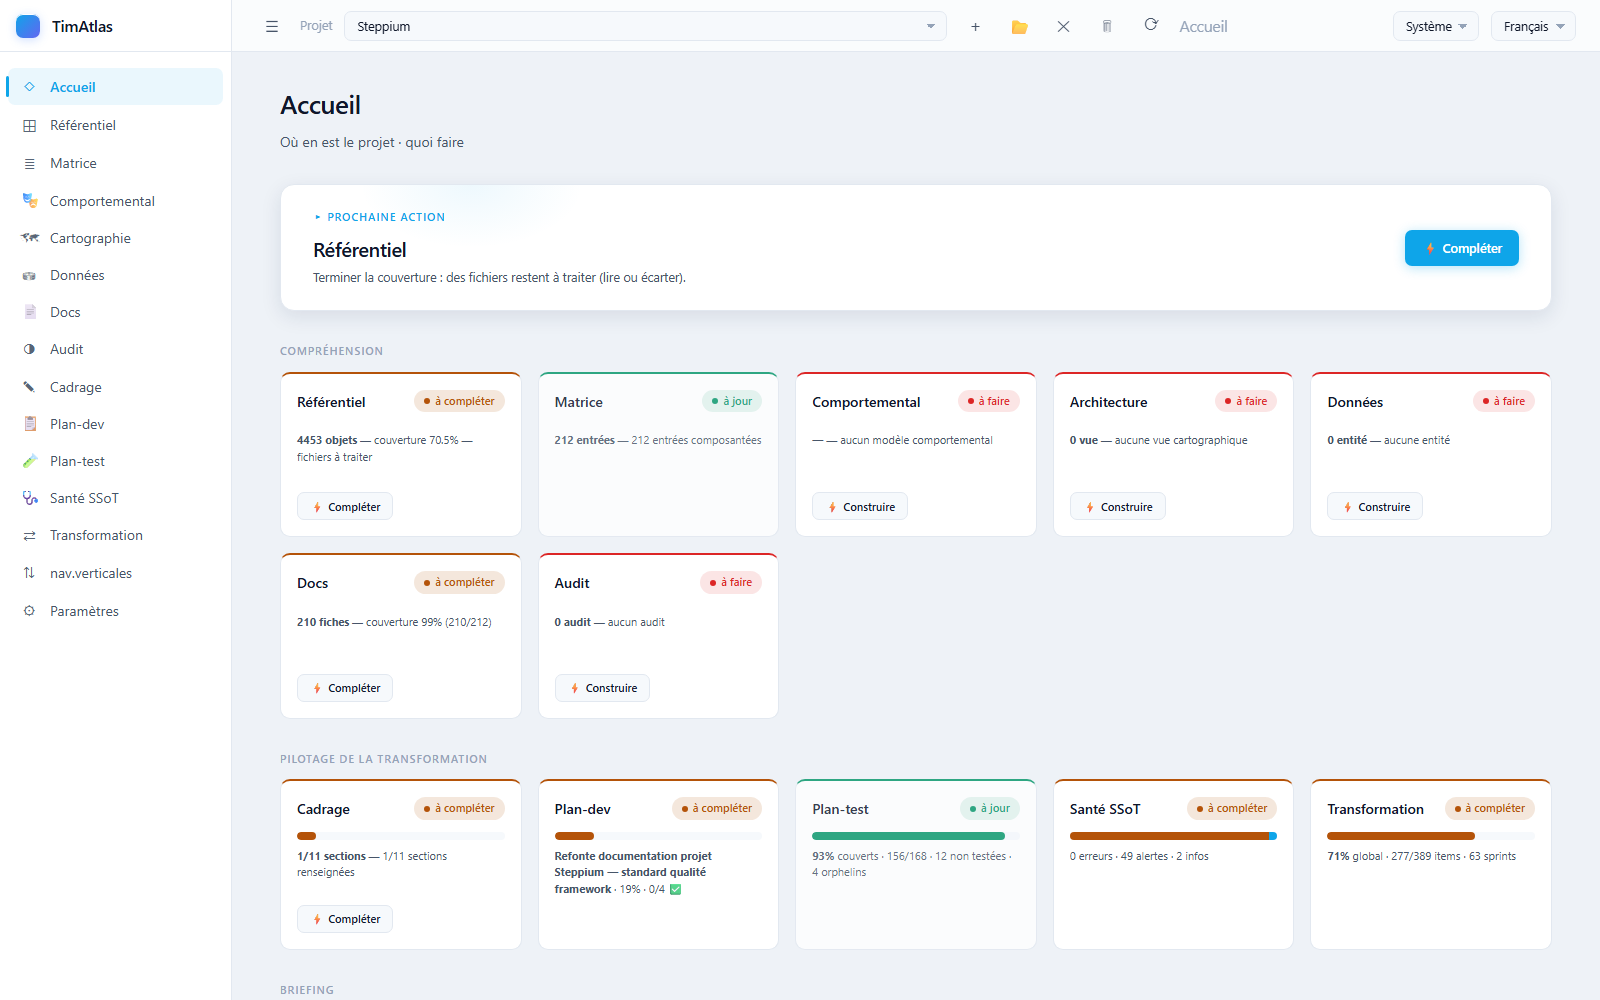
Le cockpit ne raconte pas le projet : il l’affiche. Un feu par étape, du cadrage à l’audit, et chaque carte est une porte qui ouvre son livrable. Le vert se dégrade tout seul quand la réalité bouge — un audit qui vieillit, une documentation qui décroche, un test qui manque.
Une carte qui ne sait pas dire vrai ne s’affiche pas.
Trois écrans, non retouchés
Captures prises le 15 septembre 2026 sur Steppium, notre propre solution agentique, conçue et documentée avec TimAtlas. Le référentiel, la route, un livrable.
Chaque fonctionnalité, son code et ses tests
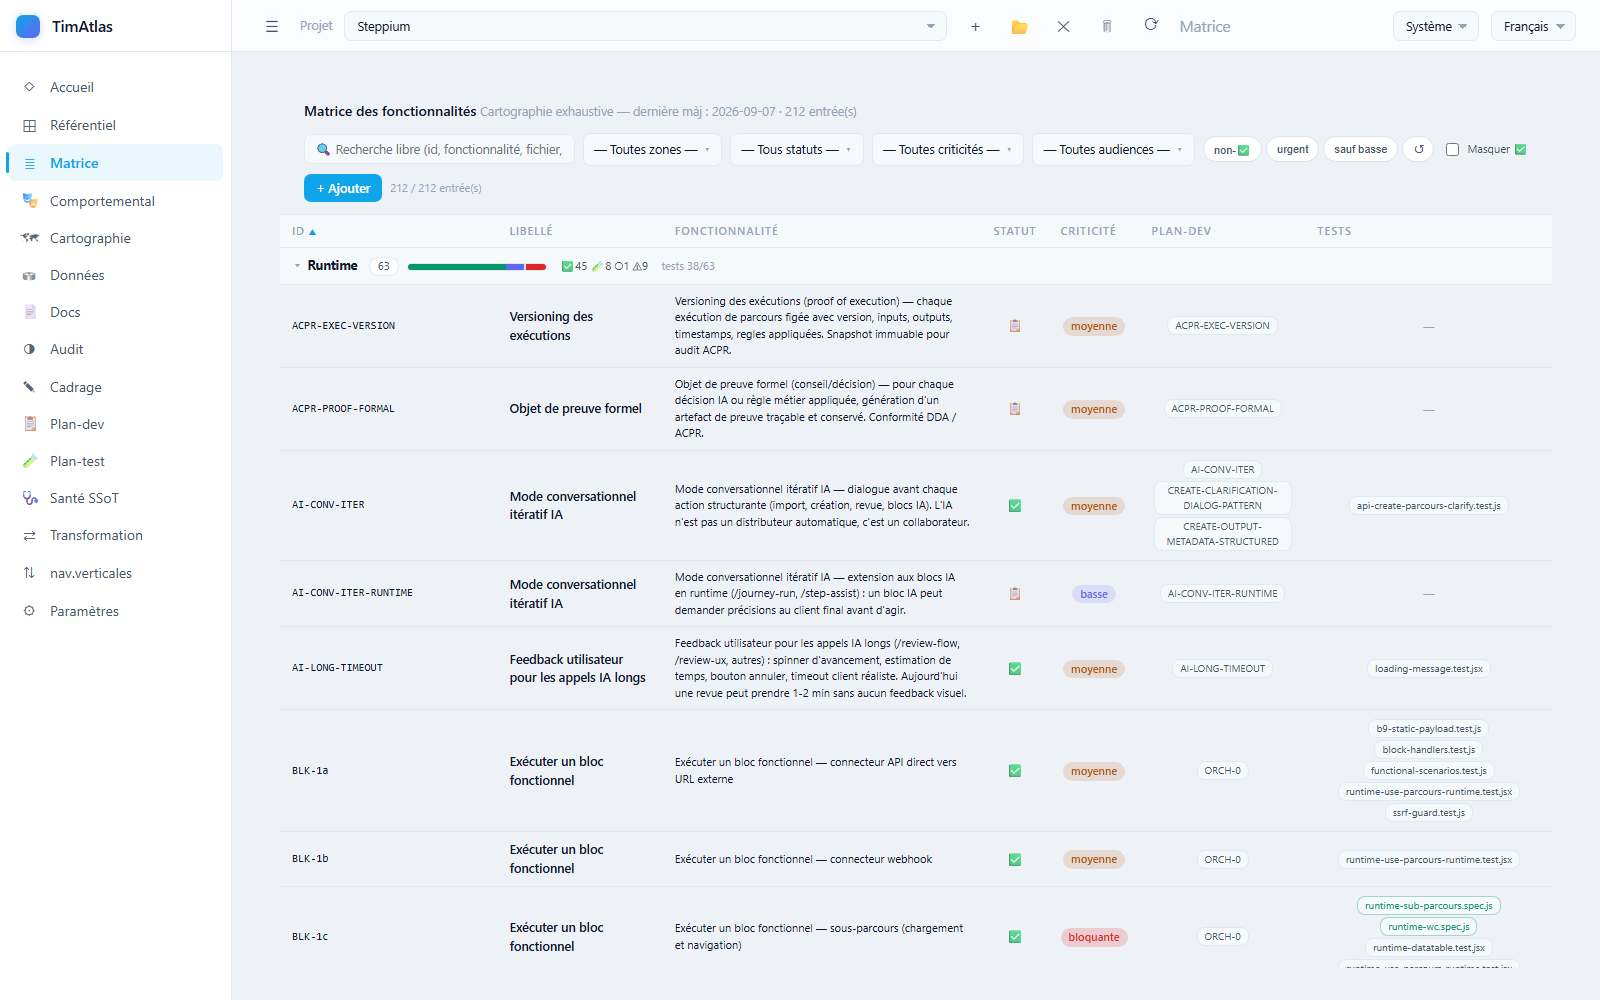
212 entrées pour Steppium, et pour chacune : la zone, le statut, la criticité, l'item de plan-dev qui la porte et les fichiers de test qui la couvrent. C'est cette table qui permet de répondre en dix secondes à « qu'est-ce qui casse si je touche ça ? » — et de voir ce qui n'est couvert par aucun test.
La route à parcourir, telle qu’on la tient
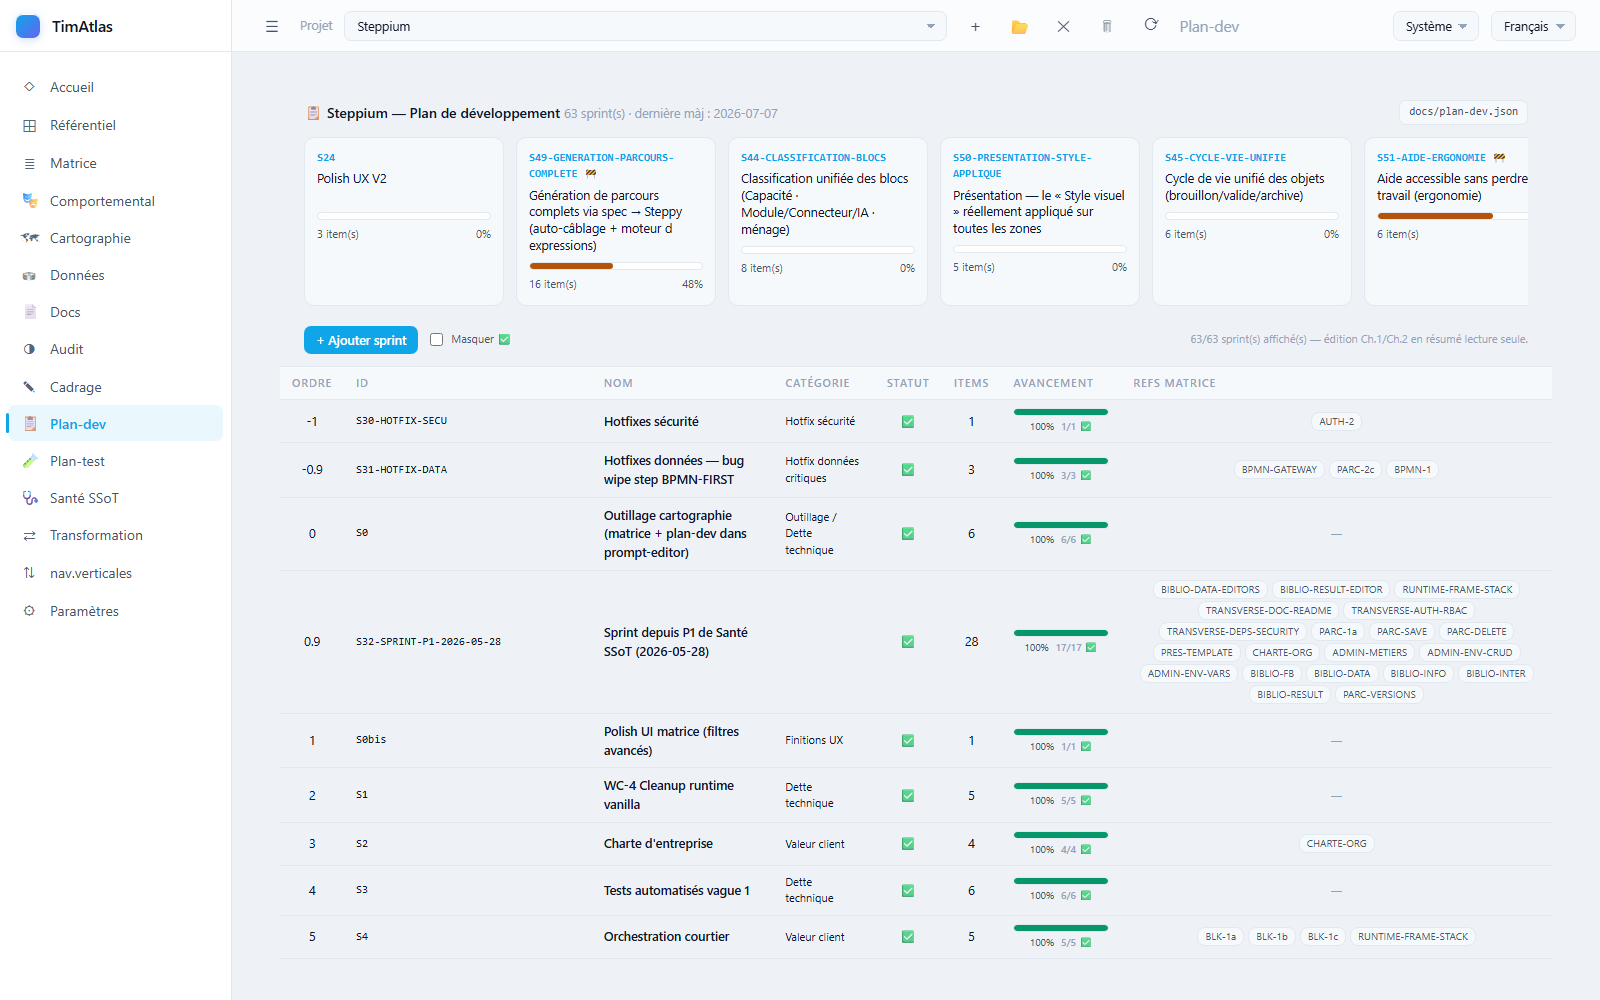
63 sprints, leurs items, et l’avancement réel — mesuré, pas déclaré. Chaque item renvoie à l’exigence qu’il satisfait : vous savez pourquoi il est là, et ce qui tombe si vous le retirez. Et le statut ne ment pas sur l’état d’avancement — « implémenté » et « validé par vous » sont deux colonnes différentes, pas la même.
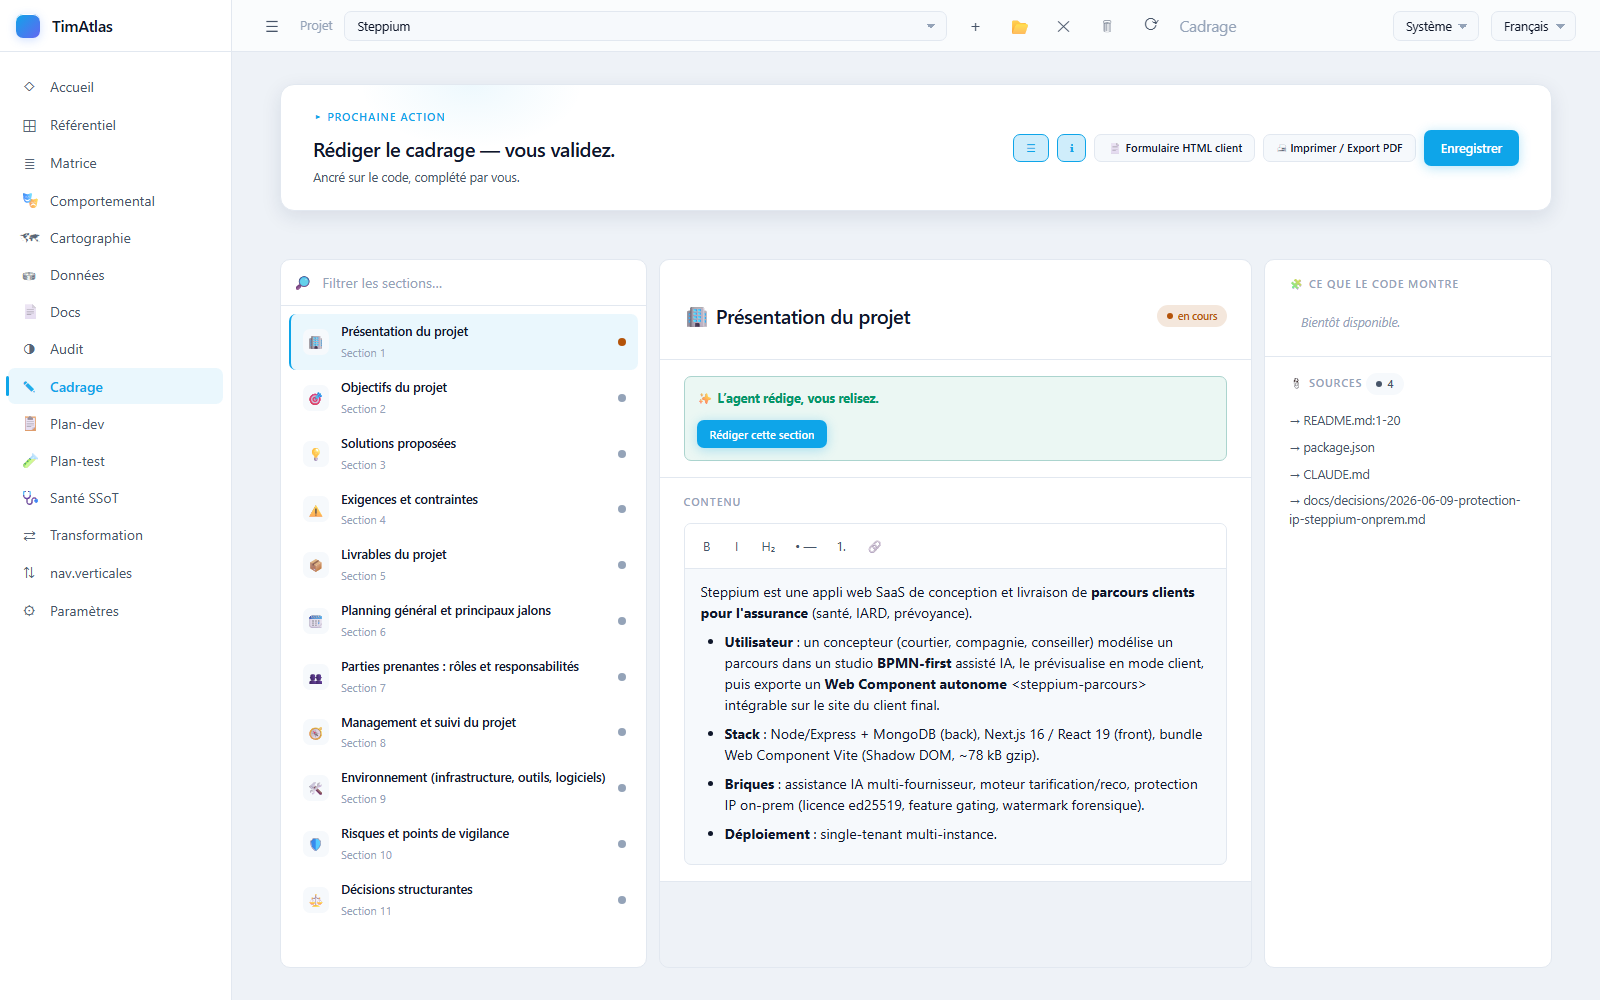
Le document de cadrage, et ses sources en clair
Onze sections, rédigées par l’agent — et chacune affiche ce sur quoi elle s’appuie. Sur cette capture, un cadrage construit sur un dépôt existant : README.md:1-20, package.json, les décisions d’architecture. Sur un système à construire, ce sont vos décisions qui s’affichent là, de la même façon. Vous relisez, vous corrigez, vous validez. Export PDF ou formulaire client.
Et sur du code que vous n’avez pas écrit
Un référentiel se construit à partir de preuves — il se construit donc aussi sur du code que personne chez vous n’a écrit, y compris très ancien. Plus de 170 grammaires, du mainframe au web : RPG, Easytrieve, EGL, Clist, JCL, Assembleur z/OS. Un langage est lu par sa grammaire, ou il est déclaré non supporté : jamais d’approximation silencieuse.
Mainframe et systèmes historiques
Le cœur du sujet quand il s'agit de reprendre un existant : le code métier des années 80 se lit par grammaire, pas par échantillonnage.
COBOL : grammaire Cobol85 (ANTLR) précédée d'un précompilateur maison. La fidélité se mesure sur VOTRE corpus avant d’être annoncée — nous ne publions pas un taux obtenu ailleurs.
Langages applicatifs
Les couches récentes du système, celles qui ont été posées par-dessus l'existant — et qu'il faut relier au reste.
Analysés par arbre syntaxique — tree-sitter ou ANTLR selon le langage.
Données, configuration, exploitation
Ce qui décide vraiment du comportement en production, et qui manque presque toujours à la documentation d'origine.
Les schémas de base alimentent directement le modèle de données.
Et celui qui vous manque
Un dialecte s'ajoute par une ligne dans la table de sourcing, pas par une branche de code : la différence entre deux dialectes est traitée comme une donnée. Règle d'entrée : grammaire normative d'abord, communautaire ensuite, jamais rien d'écrit à la main.
Nous avons besoin d’un corpus représentatif de votre dialecte pour mesurer la fidélité avant de l’annoncer.
Les livrables sortent du référentiel, pas d’un modèle de Word
Chaque document est assemblé depuis le référentiel, avec ses visuels tirés des mêmes sources. Quand une information manque, le document affiche un encart « À compléter » à l’endroit exact — il ne comble jamais le trou par une phrase plausible.
Documentation fonctionnelle
Pour l’AMOA et le métier : promesse de valeur, audiences, périmètre, cas d’usage, parcours, vue fonctionnelle, capacités par zone, règles métier, limites et risques.
Gabarit imposé : 12 sections, 600 lignes et 4 visuels au minimum, vérifiés par un validateur.
Dossier d’architecture
Pour les développeurs, les architectes et la production : les couches du contexte métier jusqu’à l’exploitation, avec les cartographies insérées à leur place.
24 sections au minimum, 1 000 lignes, 8 visuels — contrôlés par le validateur, pas par la bonne volonté du rédacteur.
Manuel utilisateur
Démarrage, tutoriel, référence fonctionnelle en QQOQCP, recettes, annexes. L’agent rédige l’ébauche fiche par fiche, vous relisez fiche par fiche.
Chaque fiche naît « à valider » et ne passe à « fait » que par une main humaine. 74 fiches sur notre propre produit, et le compteur est affiché.
Rapport d’audit
Synthèse exécutive, compréhension du système, modèle de données, méthode, scoring par famille, conformité, recommandations — et huit annexes de preuve.
Nos notes internes de reprise sont un document séparé : le client reçoit le rapport, pas notre cuisine.
Note de cadrage
Onze sections rédigées depuis le dépôt — présentation, objectifs, solutions, exigences, livrables, planning, parties prenantes, risques, décisions structurantes. Chaque section affiche ses sources en clair, à la ligne près.
Ancrée sur le code, complétée par vous : l’agent propose le texte, vous le corrigez et vous le validez.
Restitution client
Ce que nous avons compris de votre système après lecture — et surtout les questions auxquelles votre code ne répond pas, celles qu’il faut vous poser à vous.
Aucune question posée sans la preuve qui la motive : la restitution cite le fichier qui l’a soulevée.
La machine mesure. L'IA nomme. Vous tranchez.
Un moteur déterministe lit le dépôt et en tire un noyau de faits : chaque fait porte sa valeur, la règle nommée qui l'a produit, l'evidence fichier:ligne et son niveau de preuve. Ce moteur ne contient aucun appel à un modèle de langage — il se rejoue à l'identique. L'IA intervient ensuite pour nommer, regrouper et rédiger. Elle ne décide jamais de ce qui est vrai.
Le partage des rôles
- ✓ Tout fichier du périmètre est touché — aucun échantillonnage
- ✓ Chaque fait renvoie à la ligne de code qui le porte
- ✓ Rien ne s'écrit sans vous : chaque modification s'affiche avant d'être autorisée
- ✓ L'analyse d'impact tombe avant la décision, pas après
- ✓ Exports ouverts : Archi (.archimate), BPMN 2.0, CMMN 1.1, XMI, PlantUML, Mermaid, SVG
Trois garanties qui tiennent en une phrase.
La machine mesure. L'IA nomme et produit, sans jamais être crue sur parole. Vous tranchez — rien ne s'écrit dans votre référentiel sans vous.
Le framework est l'usine, votre produit est la voiture. Si l'usine ferme demain, la voiture roule toujours : aucune dépendance à l'exécution, aucune redevance au runtime.
Une application de bureau, sur votre poste. Compatible on-premise et air-gap : votre code ne part nulle part, et vos exports s’ouvrent dans Archi ou dans n’importe quel outil BPMN 2.0.
Aucun fait sans la ligne de code qui le porte. Ce qui n’a pas pu être établi est nommé et daté — jamais deviné, jamais comblé.
Un système à concevoir, ou un existant à reprendre ?
Les deux se traitent avec le même référentiel. En trente minutes, l'atelier tourne en direct devant vous — sur un système à construire, ou sur votre propre dépôt. Nous vous dirons franchement ce que le framework apporte dans votre cas, et ce qu'il ne résoudra pas.
« Un fait ne vaut que par la ligne qui le porte. »
Demander une démonstration